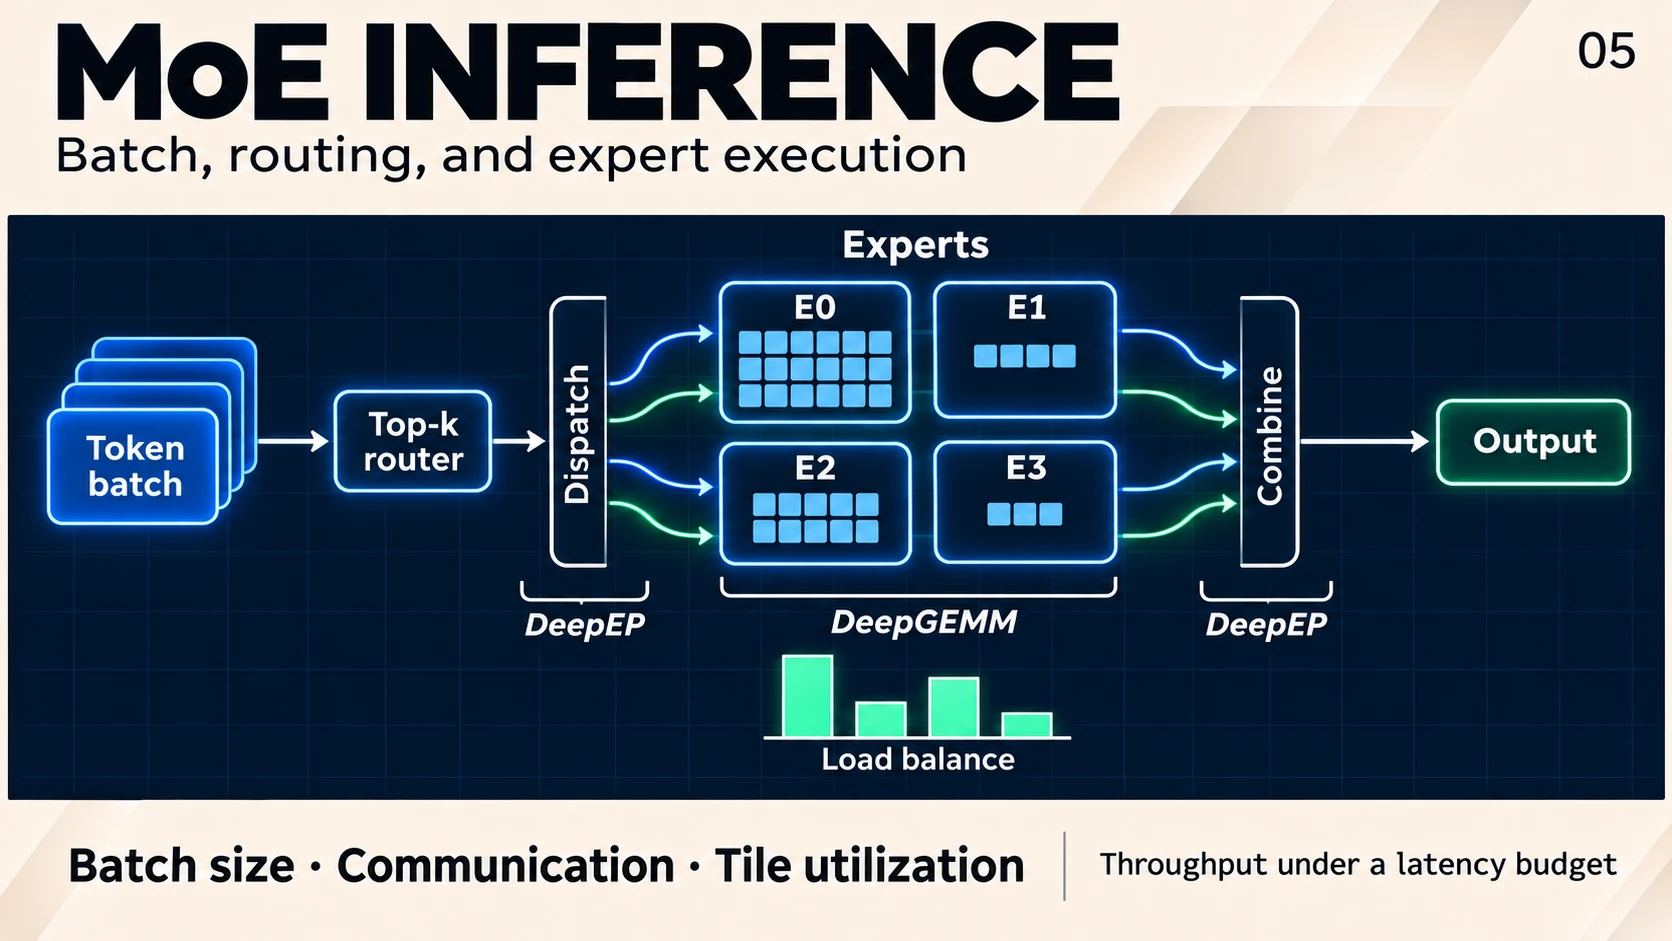
沿着 batch 这条主线,分析专家覆盖率、通信量、tile 填充和负载倾斜,并用端到端实测校验理论预算。
Shape 与稀疏度的演变
| 模型 | E(routed) | k | 专家 inter | 稀疏度 | 形态 |
|---|---|---|---|---|---|
| 稠密 FFN (Llama-70B) | — | — | 28672 | 100% | 一个大 GEMM |
| DeepSeek-V3 (2024) | 256 | 8+1s | 2048 | 5.5% | 细粒度 + shared |
| Qwen3.5 (2026) | 512 | 10+1s | 更小 | 4.3% | 超细粒度 (shared 去了又回) |
| DS-V4-Pro (2026) | 384 | 6+1s | 2048 | 3.1% | + 原生 FP4 |
趋势:E 涨 64×、单专家缩小 14×、稀疏度 25%→3%。
后果:单专家 GEMM 从”大而稠”变”小而碎”——MoE 的一切系统问题(padding、EP、EPLB)都源于这个形态变化。
MoE角度上看:RoofLine下,Batch/通信/算力的整体影响关系
看Batch对计算效率的影响:
1
2
3
4
5
6
7
8
9
10
┌─→ AI ↑ → 吞吐 ↑(稠密模型 B* 之前近乎免费;MoE 还要乘 C(B),见下)
                    │
                    ├─→ M_e ↑ → GEMM 从 padding 区推向饱和区
        B ↑ ────────┤
                    ├─→ all2all 字节 ∝ B → 通信时间 ↑(跨机时成为新瓶颈)
                    │
                    └─→ KV 池需求 ∝ B → 被显存卡住(EP 解锁)

实际运行点 = min( B*, B_SLA, B_max_mem )
              ↑吞吐最优  ↑TPOT上限  ↑显存上限
B 是唯一同时出现在四条链上的变量。 所有 MoE 系统优化,本质都是在”把 B 推高”和”消除推高 B 的副作用”之间做工程——推高 B 靠 EP 解锁显存,副作用(通信涨、padding、不均衡)则各有对应的库来治。
MoE 的“B* 之前免费”要打折:一步内命中专家的比例 C(B)=1−(1−k/E)^B 随 B 增长,读取的权重也增长。令 W_routed 为路由专家参数数、W_shared 为每步必读的其他参数数,则权重流量近似为 [C(B)·W_routed+W_shared]·bpp。只有 C(B) 接近 1 且尚未碰到计算等限制时,才可能形成近似平坦区间。
在全专家覆盖、忽略其他算子、相同分片方式的理想条件下,令读权重时间与 2·N_active·B/F 相等,得 B*≈Ridge·W_total·bpp/(2·N_active)。这是权重 GEMM 的拐点估计,不能直接等同服务吞吐最优 batch;真实运行点还受 KV、attention、通信和 SLO 约束。
| 链条 | 恶化表现 | 谁治 | 机制 |
|---|---|---|---|
| all2all 字节 ∝ B | 跨机通信成为新瓶颈 | DeepEP | 把通信从”加法项”变成”可被计算掩盖的项” |
| M_e 落在 padding 区 | 为 pad 行付算力,浪费 10× | DeepGEMM | 让静态形状容纳动态负载,pad 粒度降到真实 M_e |
| 专家负载不均 | all2all 同步屏障 → 最慢卡决定整层 | EPLB | 打散热专家,把 max/mean 压回 1 |
端到端实测校验:理论下限与服务能力分开
Qwen3.5-397B-A17B-FP8,8 卡、TP8;input 1024/output 128,关闭 radix cache,静态显存比例 0.85,decode graph 最大 batch 256。下表记录 bench_one_batch_server 的单批次采样结果。
| batch | Graph decode tok/s | TPOT | eager TPOT |
|---|---|---|---|
| 1 | 177 | 5.6 ms | 144 ms |
| 8 | 896 | 8.9 ms | 141 ms |
| 32 | 1948 | 16.4 ms | 146 ms |
| 64 | 2828 | 22.6 ms | 143 ms |
| 128 | 4136 | 30.9 ms | — |
| 256 | 5626 | 45.5 ms | — |
严格 30ms TPOT 上限下,B=128 的 30.9ms 不达标;已有采样中 B=64 的 22.6ms 达标,但并未定位最大达标吞吐。
prefill 吞吐约 26K tok/s,B=1 TTFT 74ms。自然语言 prompt 的 MTP-3 接受长度 3.07–3.11,B=1/8/32 的 TPOT 为 2.45/5.1/7.6ms;随机 token prompt 的接受长度 3.64 偏高,不用于收益结论。未开 MTP 时 B≤8 已低于 10ms,因此“10ms 必须 16 卡+MTP”不成立。
满权重读取下限 397GB / 8 / 3.33TB/s = 14.9ms 假设本步读满全部权重;小 batch 必须改用命中专家并集。B=256 的 45.5ms 约为这个理想下限的 3.1 倍,差值同时可能包含有效带宽不足、计算、通信等,不能用相减推断“其他开销占 2/3”。
DeepEP
通信量的本质:dispatch = B·C·d·1B(FP8) + combine = B·k·d·2B(BF16),其中 C = P[1−(1−1/P)^k] 是去重后的目标卡数(EP32 时 7.18,不是 k=8)。字节量随 B 线性涨,这一项无法消除,只能做三件事:
1
2
3
4
5
6
① 减字节:dispatch 走 FP8(减半);同 rank 多专家共享一份 token 数据(去重 C<k)
② 压 α:IBGDA 让 GPU 的 SM 直接写网卡 WQE、敲 doorbell,绕过 CPU proxy
        —— 跨机 all2all 是高频小包,α 而非带宽才是主导项
③ ★ 把加法变 max:hook 机制。send 发起后 RDMA 由网卡执行、不占任何 SM,
   计算 kernel 照常排队,要数据时才调 recv hook
   ⟹ TBO(双 micro-batch 重叠)踩在这个机制上,层时间从 t_comm + t_comp 变成 max(·,·)
“不占 SM”只对跨机 RDMA 成立。机内走 NVLink 时数据由 SM 自己搬,实测 EP4(E=256、k=8、d=7168)low-latency dispatch 32–50 μs、combine 30–76 μs,hook 重叠只藏住 20–27% 的通信时间。去重目标卡数实测 3.44–3.61,与公式 3.60 吻合。
两套 kernel 对口两个阶段:normal(prefill,NVLink→RDMA 非对称域转发,吃带宽)/ low-latency(decode,纯 RDMA 单跳 + 固定预分配 buffer → CUDA Graph 可 capture)。
价值定位:DeepEP 不减少通信量,它让通信不再出现在关键路径上。所以它的收益上限 = 通信占步时间的比例,在跨机大 EP 场景可达 40-60%。
DeepGEMM
MoE decode 的核心矛盾是两个约束打架:
1
2
约束 A(CUDA Graph):shape 必须静态 —— capture 时定死,replay 不能变
约束 B(MoE 现实):  每专家真实行数 masked_m[e] 每步都在变,且很小
三种做法只有一种能同时满足:
| 做法 | Graph 支持 | M_e=5 时的浪费 |
|---|---|---|
| pad 到 M_max 的稠密 batched GEMM | ✅ | 12.8× (算满 M_max) |
| CUTLASS grouped (按真实 M) | ❌ shape 每步变 | 12.8× (tile 太大) |
| DeepGEMM masked | ✅ | 3.2× (BM=16) → 1.6× (BM=8),这里是 FLOP 浪费 |
核心一招:内存静态、计算动态。buffer 形状固定为 [E_loc, M_max, K](满足 graph 要求),而 masked_m 是一个 GPU tensor——地址固定、内容每步可变,kernel 运行时读它决定实际算多少块:
1
2
m_size = __ldg(&masked_m[tile.e]);        // 运行时读该专家真实行数
if (tile.m_blk * BM >= m_size) continue;  // 纯 pad 块:一条 MMA 都不发
配套两件事:两级累加解决 FP8 深 K 精度(TC 只连累 128 个 K,CUDA core 乘 scale 升 FP32;实测全正数据、K=16K 时不升位误差约 25%,两级累加约 0.17%,等于 BF16 输出舍入);JIT 全特化可按形状选择 tile;具体版本是否使用 expected_m 改变 BM 要实测,本次 SM90 masked 路径改变 expected_m 并未改变实际 BM=64。prefill 用 contiguous 布局和较大 tile 摊薄权重重读。
为什么”纯 pad 块不发 MMA”还有浪费:跳过是按整个 tile 生效的,只要块里有一行真数据就要算满 BM 行,FLOP 浪费 = ⌈M_e/BM⌉·BM / M_e。tile 还是访存瓶颈时,这部分浪费只是 FLOP,不占时间。
BM 的临界值也是 Roofline:单个 tile 的算术强度 = 2·BM/bpp,与真实 M_e 无关。BM* = Ridge×bpp/2;以 FP8 的参考参数计算约为 37,代入实测有效吞吐后约为 42——BM 低于它时 tile 仍是访存瓶颈,pad 行藏在权重读取里近乎免费;高于它后 tile 翻成算力瓶颈,pad 行开始真金白银烧时间。实测(sglang Triton fused_moe,W8A8 block-128,8 专家 gate_up+down 共 352 MB,M_e ≤ 16):BM=16/32/64/128 分别 118/159/202/445 μs,对应 3.0/2.2/1.7/0.8 TB/s,BM 128→16 快 3.8×;实际 kernel 在 BM≈16–24 就开始掉速,比理论拐点早。DeepGEMM 0.2.2 的 SM90 masked 路径实际用 BM=64,小 M_e 下只有 1.8 TB/s。
★ 两库咬合:DeepEP 的 recv_count[num_local_experts] 就是 DeepGEMM 的 masked_m,接收 buffer 直接作 GEMM 输入,零拷贝零重排。
EPLB
all2all 是同步屏障 → MoE 层时间 = 最忙卡的时间 → 慢 S₀ = max_load/mean_load 倍。倾斜有两个独立来源,只有一个能治:
1
2
3
4
① 统计涨落:S₀ ≈ 1 + √(2lnP) · CV_gpu,其中 CV_gpu = CV_e/√e(卡内 e 个专家自平均)
   B_local=48 时地板约 ±13% —— ★ EPLB 治不了,只能靠加大 batch
② 路由热点:S₀ ≈ 热冷比 r(坏 placement 时)
   ⟹ EPLB 复制热专家 + LPT 装箱打散,把 S₀ 压回 ~1.1
收益换算(注意两级摊薄):
1
2
3
4
MoE 层提速 = S₀/S₁
端到端     = 1 / ( f/(S₀/S₁) + (1−f) )        f = 可均衡占比
             ↑ EPLB 同时均衡 GEMM 和每卡 a2a 接收量(都 ∝ 专家负载)
               治不了的:总字节量、α 地板、attention
| 场景 | e(每卡专家) | CV_e | S₀/S₁ | f | 端到端 |
|---|---|---|---|---|---|
| EP32,B=48,跨机 | 8 | ~0.35 | 1.18 | 0.6 | 1.10× |
| SGLang EP72 decode | 4 | ≥1.3 | ~2.6 | 0.85 | 2.54× |
★ EPLB 的收益由三个因子决定,缺一不可:热点程度(CV_e)、每卡专家数(e 越小越无自平均)、可均衡占比(f)。e=8 + 大 batch + 均匀路由 = 10% 就是天花板,不是实现问题;要看到 2× 级收益,需要 EP64+/e≤4 + 真实重尾路由 + 配冗余专家。
系列导航
| 章节 | 文章 | 编排日期 |
|---|---|---|
| 0 | Roofline:用算力与带宽建立性能预算 | 2026-01-01 |
| 1 | 通信模型:从集合原语到跨机拓扑 | 2026-02-13 |
| 2 | 分布式推理:TP、DP、EP、CP 与 PP 的取舍 | 2026-03-29 |
| 3 | 推理硬件:GPU、NPU 与存储层级 | 2026-05-11 |
| 4 | Attention 演变:从 GQA、MLA 到混合状态 | 2026-06-24 |
| 5 | MoE 推理:Batch、DeepEP、DeepGEMM 与负载均衡(本篇) | 2026-08-06 |
| 6 | PD 与 EPD:阶段分离、状态传输与资源配比 | 2026-09-19 |
| 7 | 核心优化:CUDA Graph、投机推理、Overlap 与量化 | 2026-11-01 |
上一篇:Attention 演变:从 GQA、MLA 到混合状态 · 下一篇:PD 与 EPD:阶段分离、状态传输与资源配比
交流与讨论
正在加载评论…