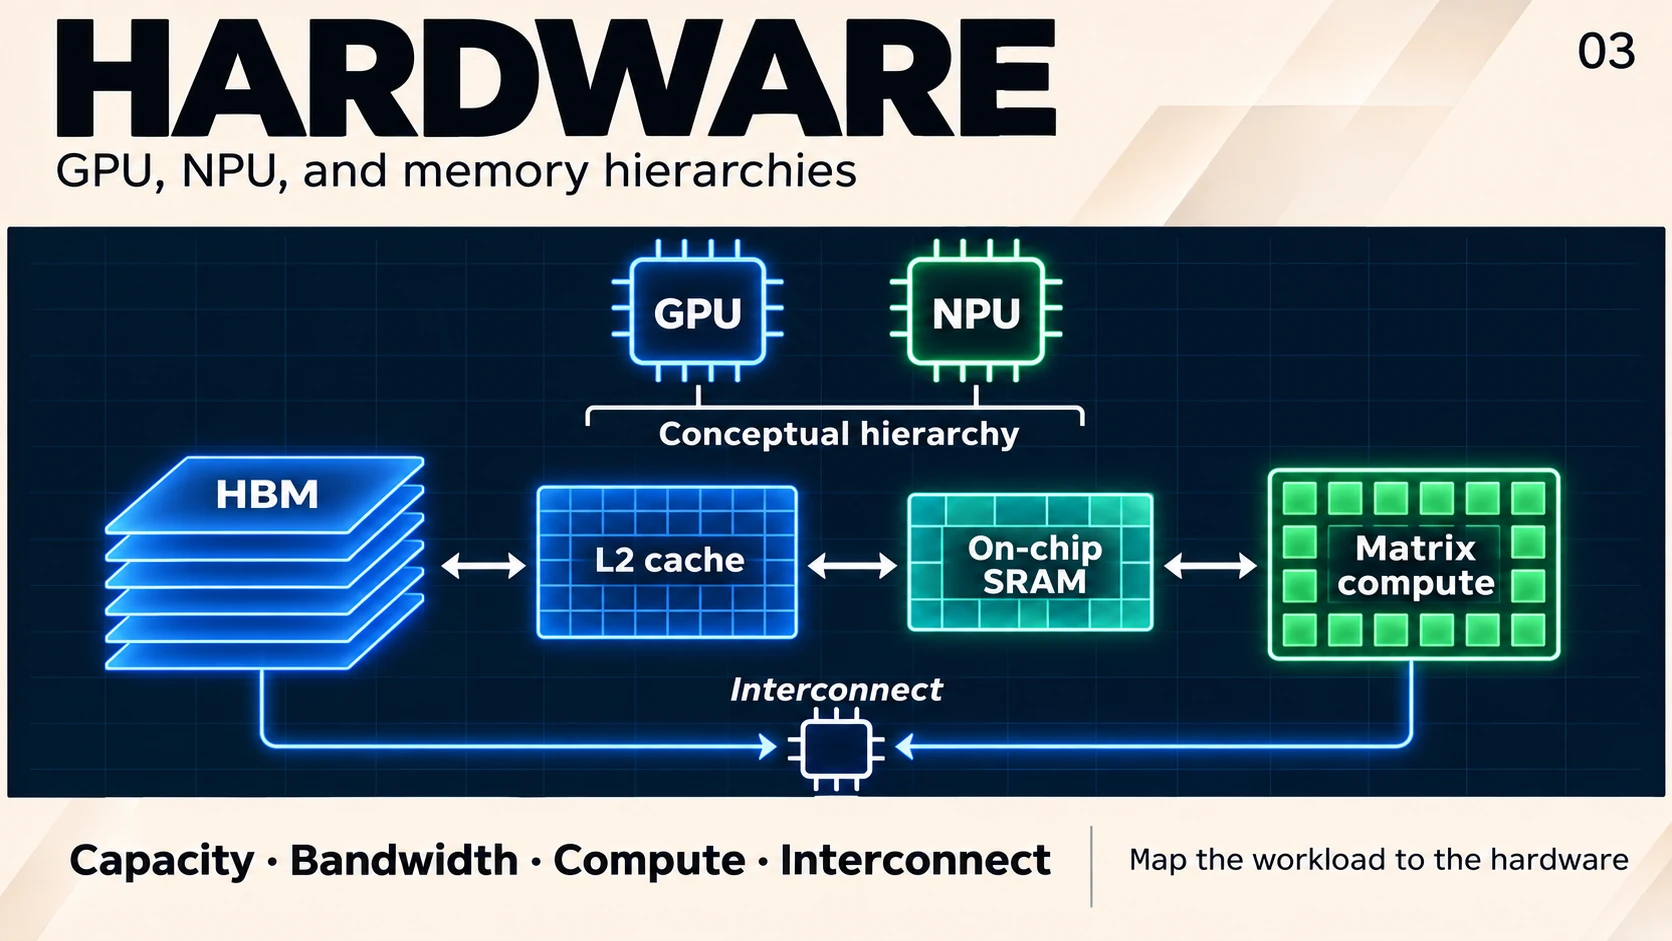
把算力、HBM、片上缓存和互联放在同一张预算表中,理解不同硬件为什么需要不同的算子与部署策略。
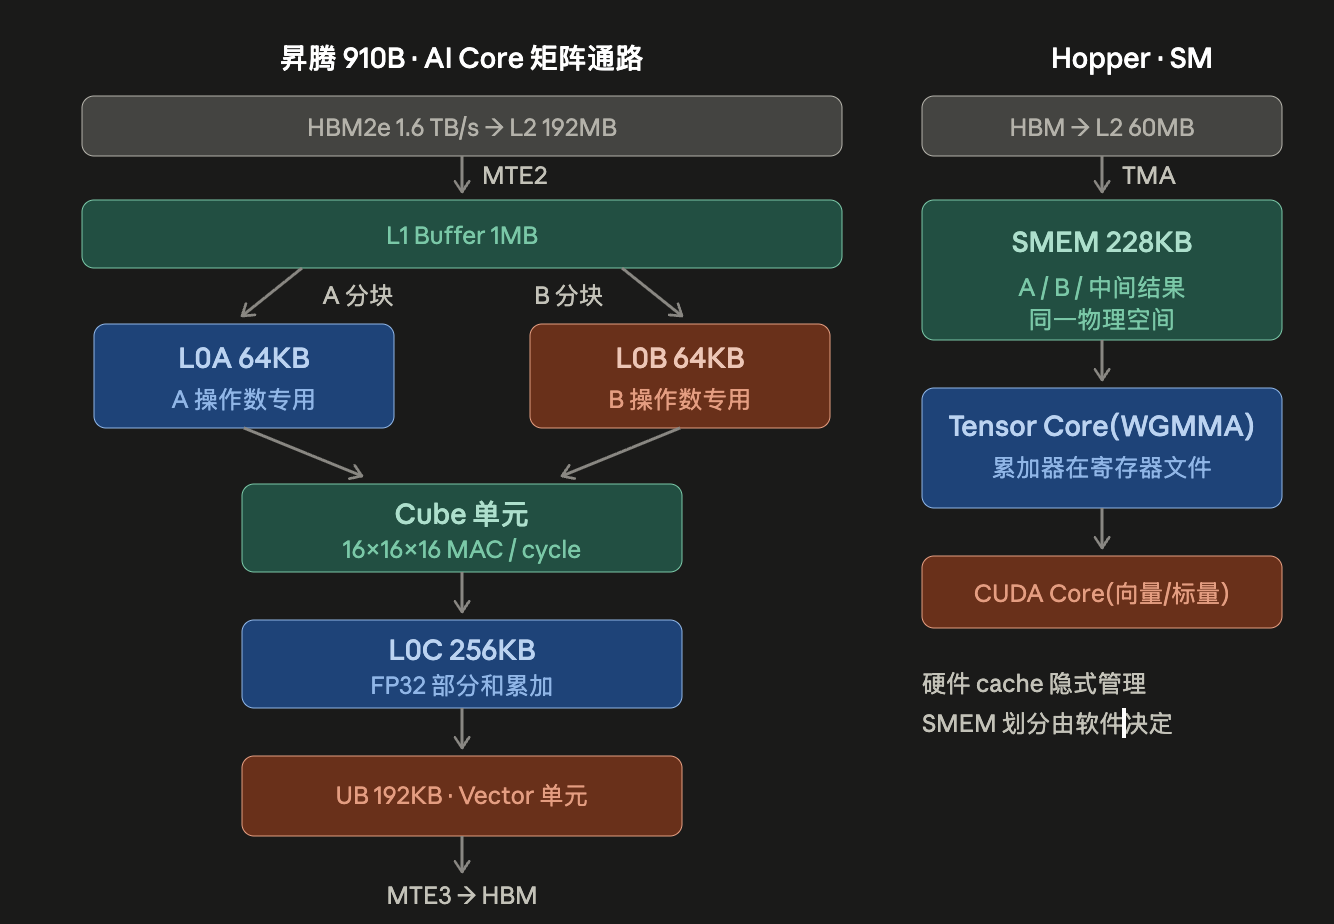
芯片架构对比:
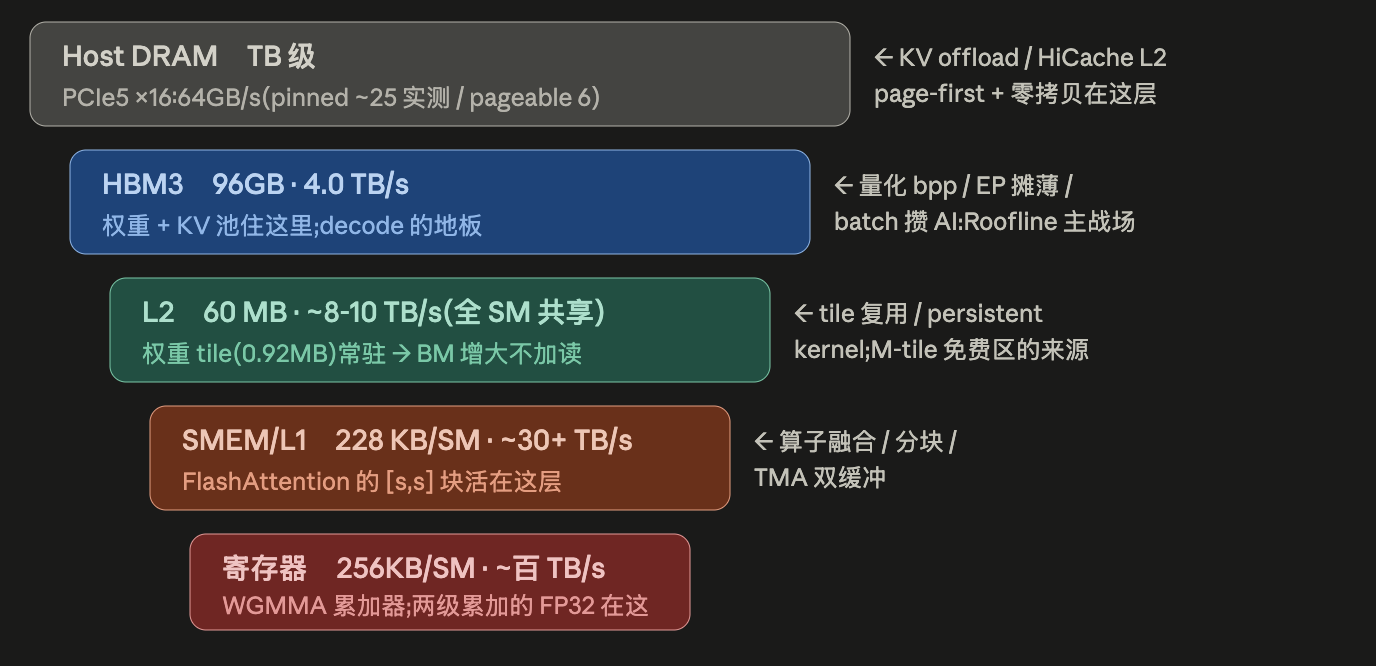
存储层级示意:
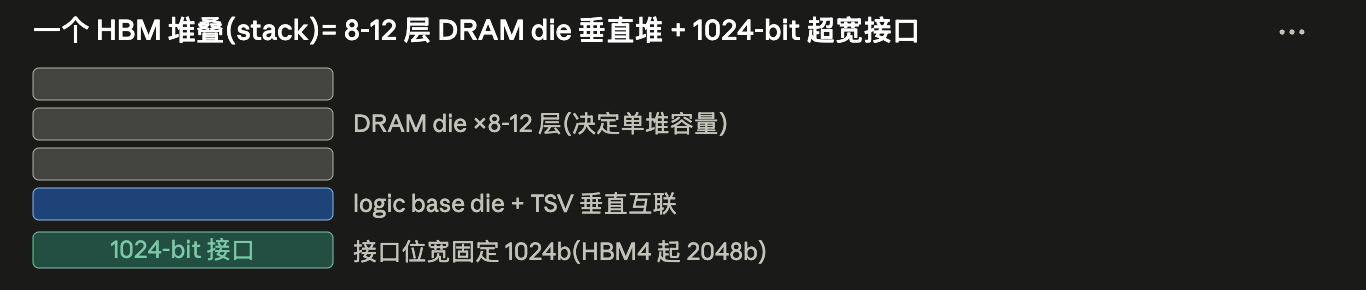
HBM堆叠示意图:
HBM颗粒版本对比:
- HBM2e:规格 3.6Gbps,910B 实跑 3.2 → 单堆 0.40TB/s × 4堆 = 64GB · 1.6TB/s
- HBM3: 规格 6.4Gbps,H100/H800 实跑 5.2 → 单堆 0.67 × 5堆 = 80GB · 3.35TB/s (公开 H20-96GB 规格为 96GB、4.0TB/s,可用于比较不同堆数下的容量与带宽)
- HBM3e:规格 8–9.6Gbps,按 H200 的公开容量与带宽反推,每堆数据率约为 6.25 → 单堆 0.80 × 6堆 = 141GB · 4.8TB/s B200 拉到 7.8 → 单堆 1.0 × 8堆 = 192GB · 8.0TB/s B300 同速率、换 12 层 die → 288GB · 8.0TB/s(带宽不变)
- HBM4: 接口 1024→2048-bit 位宽翻倍,Rubin 世代,单堆 ~2TB/s 级
说明:
容量、带宽与算力应分别比较。以公开规格为例,H20-96GB 的显存容量与带宽为 96GB、4.0TB/s,H200 为 141GB、4.8TB/s;容量增加并不意味着各条计算路径的峰值按相同比例变化。 B200→B300 只加 die 层数:容量 +50% 带宽不变 → Ridge 不变,纯为 KV 池/大模型而生
GPU:公开规格对照
H20-96GB 与 H800 的容量、带宽及计算峰值可参考 SGLang 公开报告;H200 的容量与带宽见 NVIDIA 产品说明。表中的型号用于规格比较,实测结果按后文各节列出的条件解释。
| 芯片 | 显存颗粒 | 堆数×单堆 | 容量 | HBM 带宽 | L2 | SMEM/SM(SM数) | 8卡节点 | 反推单堆带宽 | BF16(dense) | FP8 | FP4 | Ridge(BF16/FP8) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| H20-96GB | HBM3 | 6×16GB | 96 GB | 4.0 TB/s | 60 MB | 228KB(78)¹ | 768 GB | 0.67 TB/s | 148 T | 296 T | — | 37 / 74 |
| H200 | HBM3e | 6×24GB | 141 GB | 4.8 TB/s | 50 MB | 228KB(132) | 1128 GB | 0.80 TB/s | 990 T² | 1979 | — | 206 / 412 |
| H800/H100 | HBM3 | 5×16GB | 80 GB | 3.35 TB/s | 50 MB | 228KB(132) | 640 GB | 0.67 TB/s | 990 T | 1979 T | — | 296 / 591 |
| B200 | HBM3e | 8×24GB | 192 GB | 8.0 TB/s | 126 MB | 228KB(双die)³ | 1536 GB | 1.00 TB/s | 2250 T | 4500 T | 9000 T | 281 / 562 (FP4 1125) |
| B300 | HBM3e 12-Hi | 8×36GB | 288 GB | 8.0 TB/s | 126 MB | 同上 | 2304 GB | 1.00 TB/s | 2500 T | 5000 T | 15000 T | 312 / 625 (FP4 1875) |
¹ 不能仅凭 SM 数推算计算峰值:不同 SKU 的 Tensor Core 吞吐配置可能不同。H20 的公开 BF16 峰值为 148T,应直接用于对应精度的预算。
² 显存容量与带宽相近的设备也可能有不同的计算峰值。选型时分别核算容量、有效带宽和目标精度的吞吐,不按单一指标排序。
³ B300 vs B200 的算力列读法:FP4 +67%、FP8/BF16 只 +11% ——偏科升级,FP4 特化推理 SKU(另砍 FP64 到 1.2TF、attention 单元 2×,表里放不下写在备注)。
实测:计算、访存与数据传输
以下记录同一测试配置下的测量结果(单卡显存 96GB,驱动 550,SM 时钟约 1980MHz,功耗峰值约 300W)。这些结果用于分析有效吞吐与固定开销,不作为所有设备的性能承诺。
| 项 | 实测 |
|---|---|
| 算力 | BF16 138T(93%)、FP8 282T(95%)、DeepGEMM blockwise FP8 264–272T |
| HBM | copy 3.33 TB/s、只读 3.2–3.3、只写 3.4(83–85%)⟹ R_eff ≈ 42 / 85 |
| 片上 | 78 SM、L2 60 MB、SMEM 228 KB/SM(单 block 227 KB) |
| NVLink | 18 × 26.56 GB/s = 478 GB/s/方向;P2P 拷贝 395 GB/s |
| PCIe | Gen5 ×16,pinned H2D/D2H 54–55 GB/s,预分配 pageable 13–16 GB/s |
| 网卡 | 4 × 400G RoCE bond(NIC0–3 分别与 GPU1/3/4/6 同 PCIe switch),单网卡 RDMA 392 Gb/s |
| 下发 | 裸 cudaLaunchKernel 1.9 μs;PyTorch eager 4.5–12 μs/op;cudaGraphLaunch 主机侧 2.9 μs,GPU 侧每节点 0.76 μs |
NPU
| 芯片 | 封装内 die | 单 die (计算单元实际可用) | 单卡聚合 (两 die 各干各的总和) | Ridge (单 die) | 机内互联 / scale-up 域 | 机间 |
|---|---|---|---|---|---|---|
| 910B | 1 | 64 GB / 1.6 TB/s / 376T¹ | = 单 die | 235 | HCCS 392 GB/s (56×7 full-mesh) | 8 卡 200G RoCE, 1:1 (25 GB/s) |
| 910C | 2 | 64 GB / 1.6 TB/s / ~376T | 128 GB / 3.2 TB/s / ~800T | 235 | die 间带宽未公 384 卡 (CloudMatrix, UB 光互联) |
未公布 |
| 950PR (26Q1) | 未公布 | — | 112 GB / 1.4 TB/s / FP4 1.56P | — | 8192 卡 (Atlas 950 SuperPoD) | 灵衢 ~2TB/s |
| 950DT (26Q4) | 未公布 | — | 未公布 (颗粒 HiZQ, 自研) | — | 未公布 同上 |
同上 |
NPU 部署仍按计算、访存、下发分别诊断:矩阵运算走 Cube,向量/标量碎操作可能限制流水;图模式降低 host 下发,融合减少中间张量与碎操作,但不能把任意 Vector 运算都变成 Cube 运算。HCCS 机内与 RoCE 跨机要分别建模,8 卡节点的 EP16 已跨机;先确认实际拓扑和可用链路,再选择集合通信算法,不沿用模拟表里的固定 7× 加速。
系列导航
| 章节 | 文章 | 编排日期 |
|---|---|---|
| 0 | Roofline:用算力与带宽建立性能预算 | 2026-01-01 |
| 1 | 通信模型:从集合原语到跨机拓扑 | 2026-02-13 |
| 2 | 分布式推理:TP、DP、EP、CP 与 PP 的取舍 | 2026-03-29 |
| 3 | 推理硬件:GPU、NPU 与存储层级(本篇) | 2026-05-11 |
| 4 | Attention 演变:从 GQA、MLA 到混合状态 | 2026-06-24 |
| 5 | MoE 推理:Batch、DeepEP、DeepGEMM 与负载均衡 | 2026-08-06 |
| 6 | PD 与 EPD:阶段分离、状态传输与资源配比 | 2026-09-19 |
| 7 | 核心优化:CUDA Graph、投机推理、Overlap 与量化 | 2026-11-01 |
上一篇:分布式推理:TP、DP、EP、CP 与 PP 的取舍 · 下一篇:Attention 演变:从 GQA、MLA 到混合状态
交流与讨论
正在加载评论…